llms.txt, AI 검색 최적화에 정말 효과가 있을까? 직접 실측해 보았다.
llms.txt를 만들어 두면 ChatGPT나 Perplexity 같은 AI 검색에서 내 사이트가 더 자주 인용될까?
AI 답변에 인용되도록 사이트를 개선하는 GEO(생성형 엔진 최적화) 체크리스트를 찾아보면, 이 파일은 거의 빠지지 않고 등장한다.
AI 답변의 출처 링크가 새로운 유입 경로가 되면서, 이런 체크리스트를 적용하는 사이트도 늘었다.
나도 계산기 사이트에 llms.txt를 작성해 배포했다. 그런데 실제 효과를 검증한 자료는 어디에서도 찾을 수 없었다.
그래서 AI 크롤러의 요청 기록과 각 회사의 문서로 llms.txt가 실제로 수집되는지 확인하고, 이 파일의 사용처를 정리했다.
llms.txt란?
llms.txt는 AI가 사이트를 참조할 때 활용하도록 만든 안내 파일이다.
사이트 루트 경로(/llms.txt)에 두고, 사이트 개요와 우선 참조할 페이지를 마크다운으로 기술한다.
| 항목 | 내용 |
|---|---|
| 제안자 | 제러미 하워드(Jeremy Howard, Answer.AI), 2024년 9월 llmstxt.org |
| 목적 | AI가 답을 만들 때 사이트의 핵심을 빠르고 정확하게 파악하게 하기 |
| 형식 | 마크다운 한 장. 사이트명, 한 줄 요약, 주요 페이지 링크 목록 |
| 구성 | 각 페이지의 마크다운판을 .md 주소로 함께 구성 |
| 제작 방식 | 직접 작성, Mintlify · GitBook · Yoast SEO · Wix 등이 생성 기능이나 플러그인을 제공 |
제안 배경
제러미 하워드가 llms.txt를 제안한 이유는 두 가지다.
- AI가 한 번에 처리할 수 있는 양에는 한계가 있다
컨텍스트 창이 예전보다 커졌어도 사이트 전체를 담기에는 작고, 낭비한 토큰은 곧 시간과 비용이다. - HTML은 AI가 해석하기에 비효율적이다
본문이 메뉴, 광고, 스크립트에 싸여 있어 순수 텍스트로 변환하기 어렵고 정확도도 떨어진다.
그래서 사이트가 직접 "핵심은 이것, 우선 참조할 곳은 여기"를 정리해 두자는 것이다.
문서의 구조
정리하는 방식은 단순하다. 마크다운 파일 하나에 아래의 구조와 같이 적는다.
# Example Docs

> 결제 API 개발 문서. 인증, 결제 요청, 웹훅을 다룬다.

## Docs
- [빠른 시작](https://example.com/docs/quickstart.md): 첫 결제 요청까지
- [웹훅](https://example.com/docs/webhooks.md): 이벤트 종류와 서명 검증

## Optional
- [변경 이력](https://example.com/changelog.md)
각 항목의 역할은 다음과 같다.
# 이름: 사이트나 프로젝트 이름. 유일한 필수 항목이다> 요약: 사이트가 다루는 내용을 한두 줄로 요약## 목록: 주요 페이지 링크와 짧은 설명## Optional: 컨텍스트가 부족하면 생략해도 되는 링크
도입 현황
형식이 단순한 만큼, llms.txt를 채택한 사이트는 급속도로 증가해왔다.
Ahrefs가 2026년 5월 트래픽이 있는 도메인 13만 7천여 개를 조사했더니 28%가 llms.txt를 도입하고 있었다.
(기술, SEO에 관심도가 높은 'Ahrefs' 고객이 표본인지라, 수치는 높게 잡힌 편이다.)
하지만 파일을 배치한다고 AI가 수집하는 것은 아니었다.
같은 조사에서 llms.txt 파일의 97%는 그달 요청을 한 번도 받지 못했다.
내 사이트의 llms.txt는 어땠을까?
AI 크롤러의 llms.txt 요청 실측
llms.txt를 배포하고 몇 달 뒤, 효과를 직접 실측해 보기 위해 조사 기간을 7일로 설정했다.
조사 기간 동안 GA4로 측정한 결과, 약 250건의 방문이 AI 답변을 통해 유입된 방문이었다.
그런데 이 유입이 정말 llms.txt 덕분인지 궁금했다.
그래서 Cloudflare 요청 기록에서 AI 크롤러가 조사 기간 동안 무엇을 요청했는지 경로별로 집계했다.
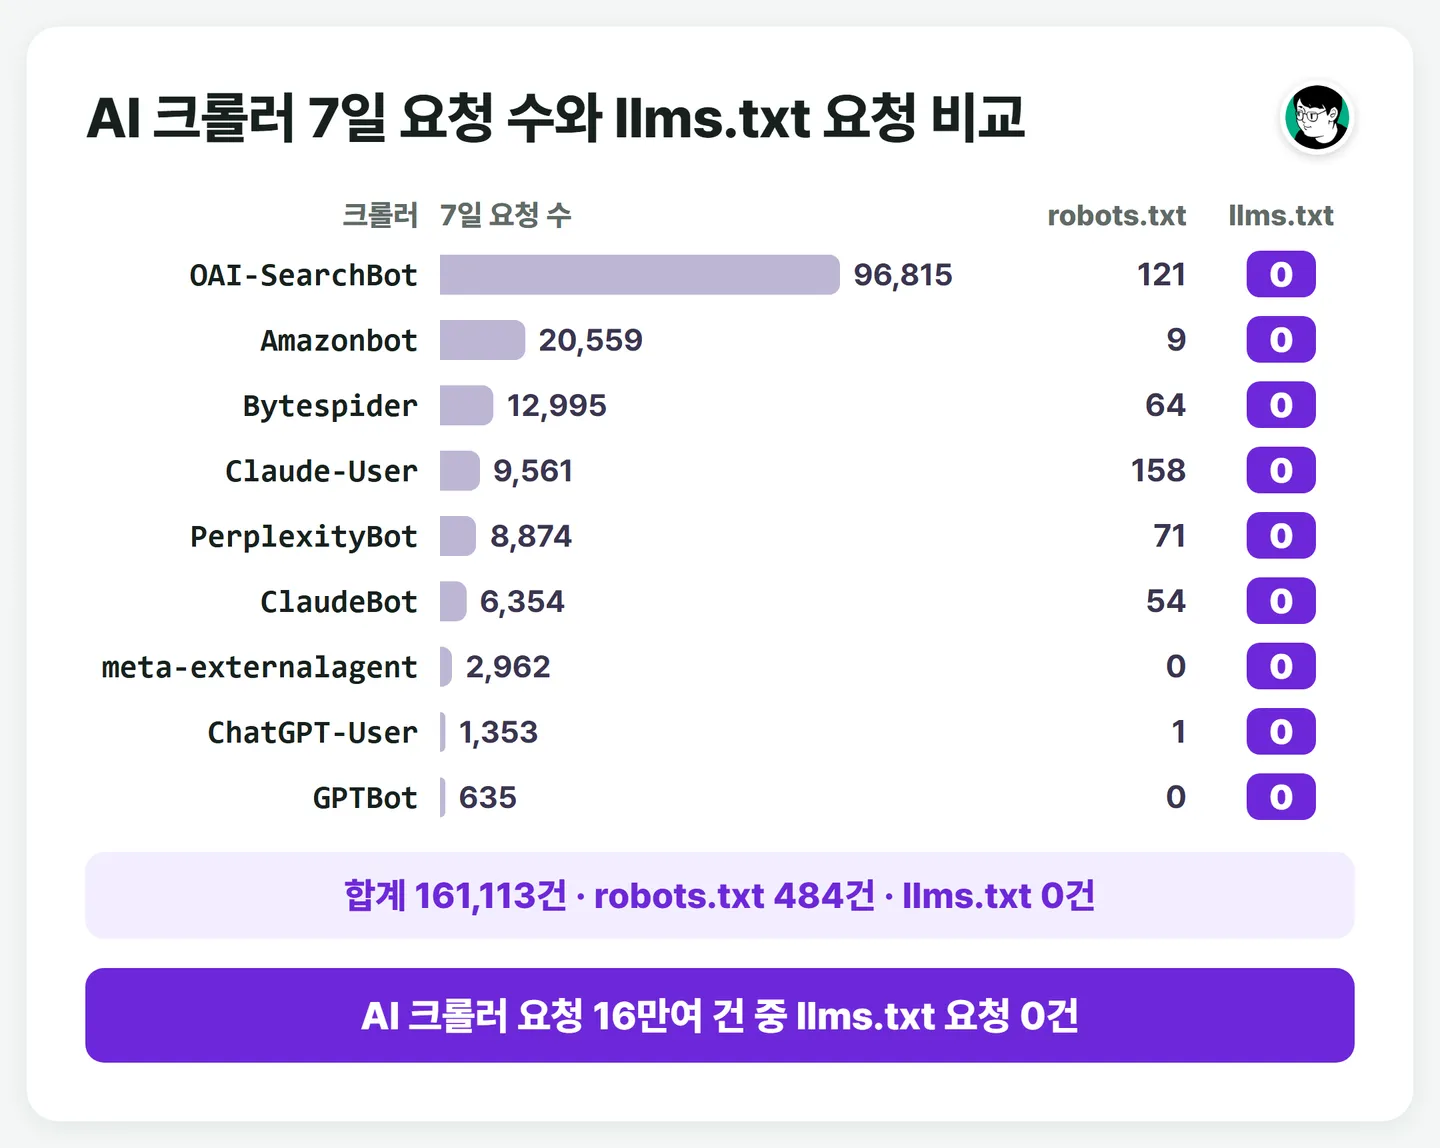
AI 크롤러 요청은 16만 1천여 건, robots.txt 요청은 484건이었다.
그런데 llms.txt 요청은 0건이었다.
16만 번 넘게 다녀가면서 llms.txt는 한 번도 열어 보지 않은 것이다.
내 사이트의 'AI 유입'은 llms.txt가 아니라, AI 크롤러가 HTML을 직접 수집한 결과였다.
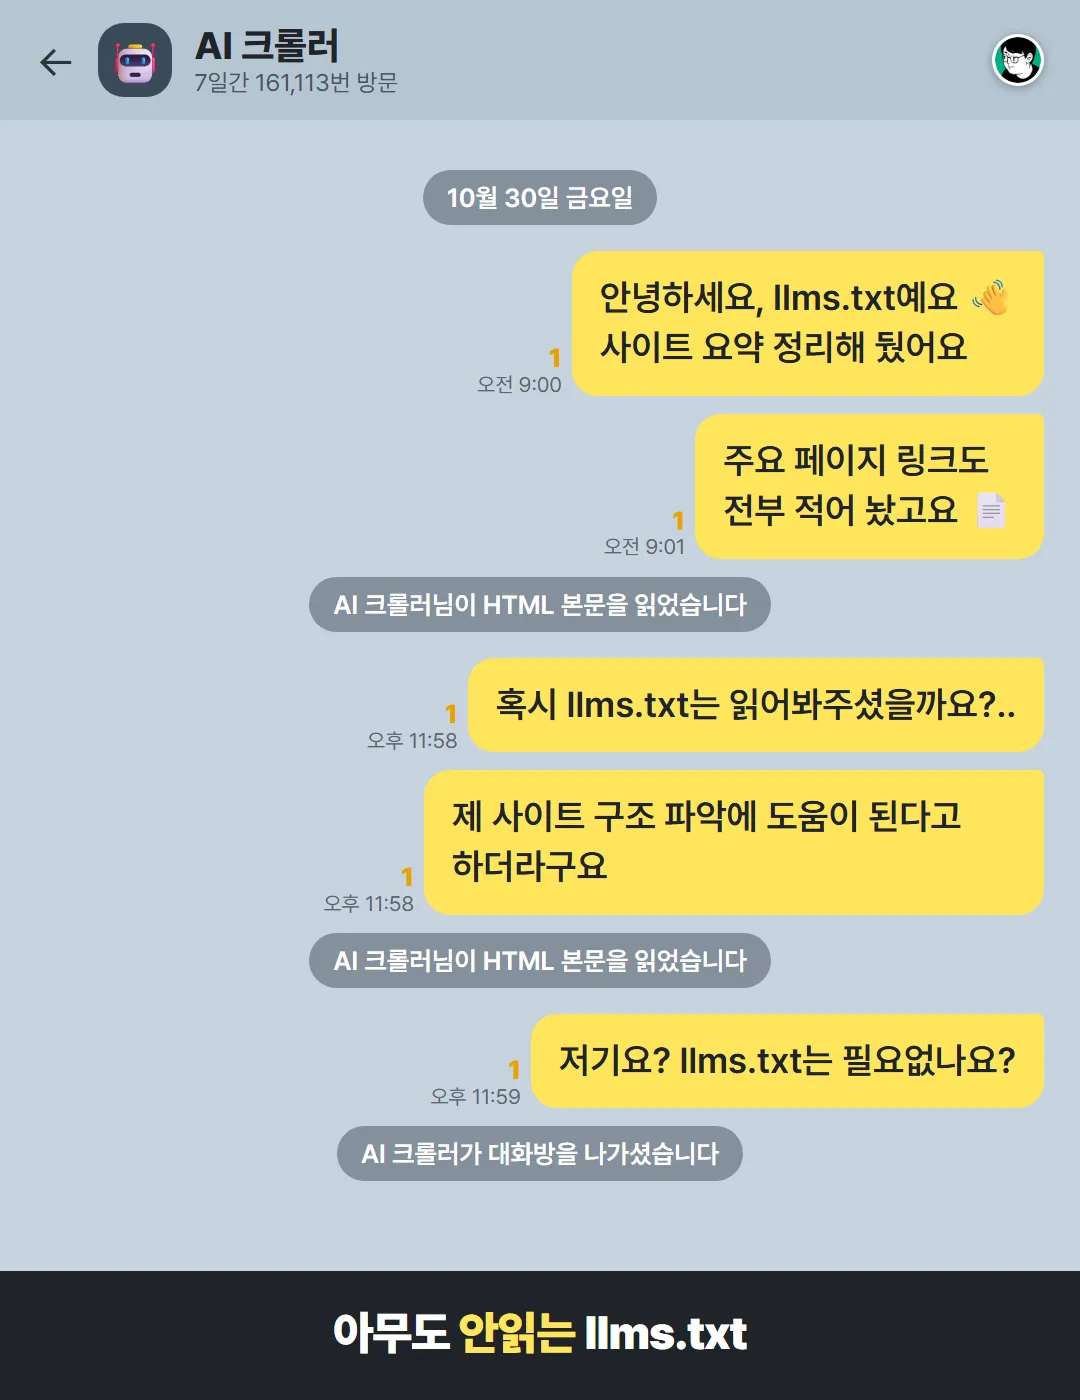
AI 크롤러가 llms.txt를 수집하지 않는 이유
같은 조사 기간 동안 robots.txt는 484번 요청됐지만, llms.txt는 0번이었다.
둘 다 사이트 루트에 배치하는 텍스트 파일인데, 왜 한쪽만 요청될까?
차이는 표준 여부에 있다.
robots.txt는 인터넷 표준으로 정해진 규칙이라, 크롤러는 수집 전에 이 파일부터 확인한다.
반면 llms.txt는 아직 제안 단계이고, 이 파일을 수집한다고 밝힌 AI 회사도 없다.
실제로 OpenAI, Anthropic, Perplexity의 크롤러 문서에도 봇 이름과 역할은 상세히 나오지만, llms.txt 수집에 대한 언급은 없다.
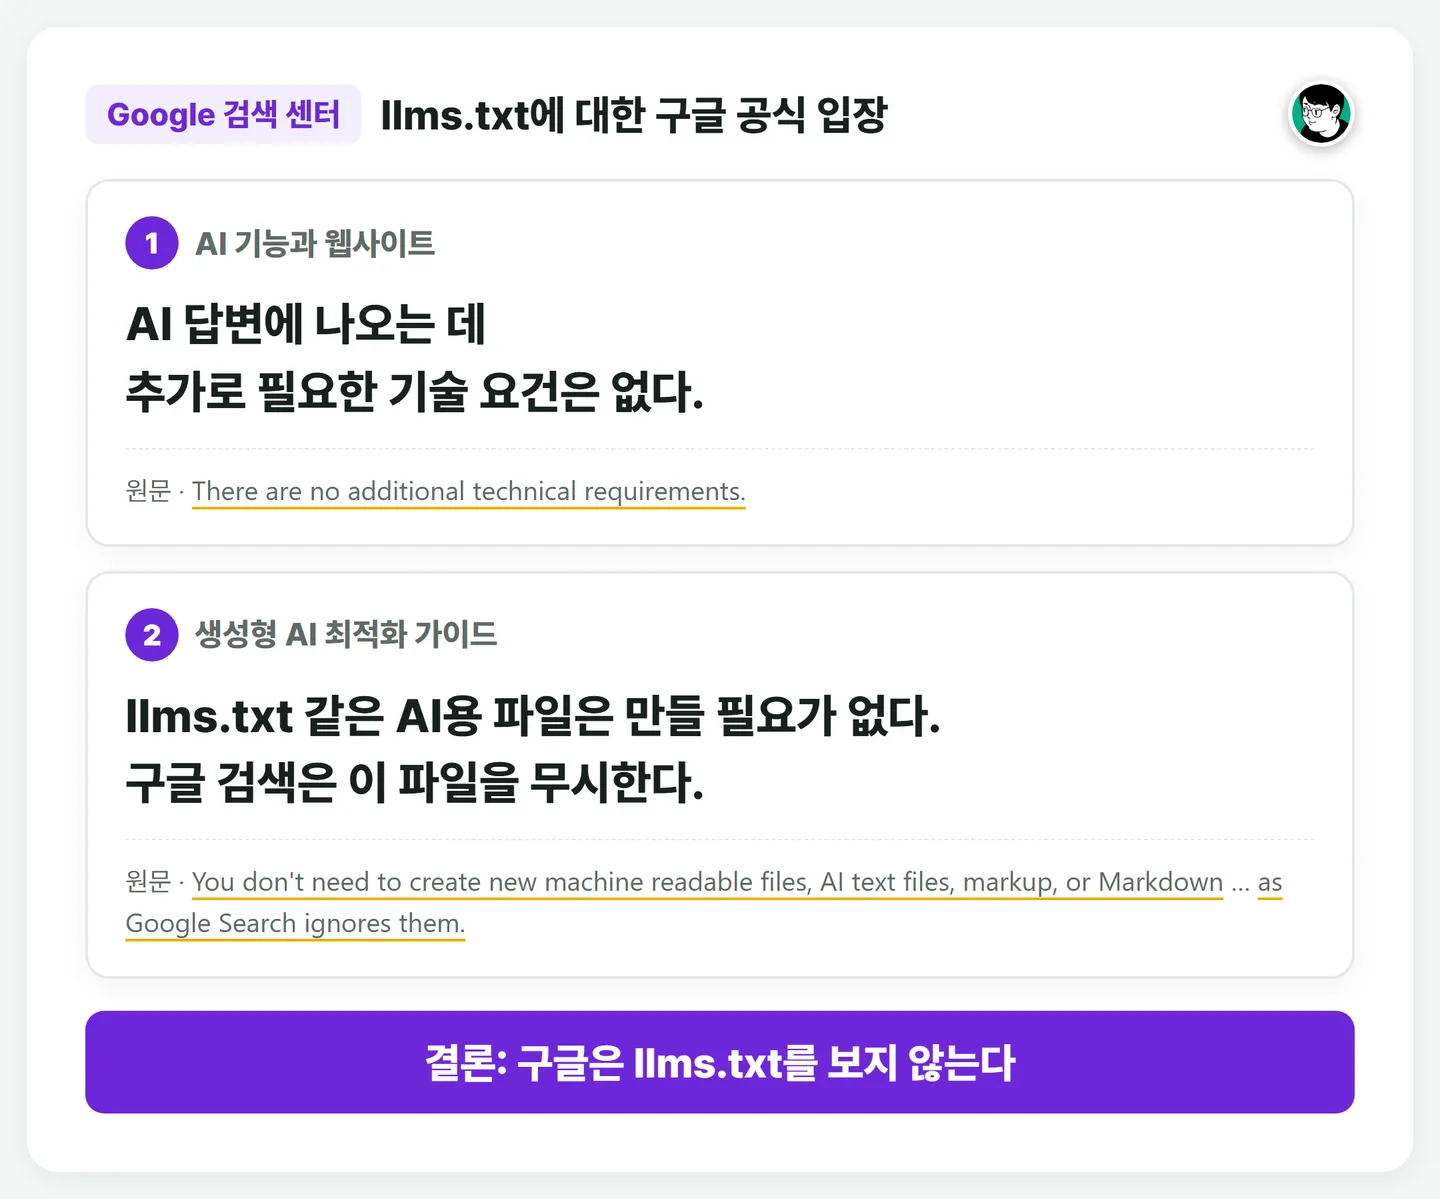
구글은 더 명확하게 밝힌다. 생성형 AI 최적화 가이드에서,
구글 검색은 이런 파일을 사용하지 않으니 새로 만들 필요가 없다고 llms.txt를 직접 언급한다.
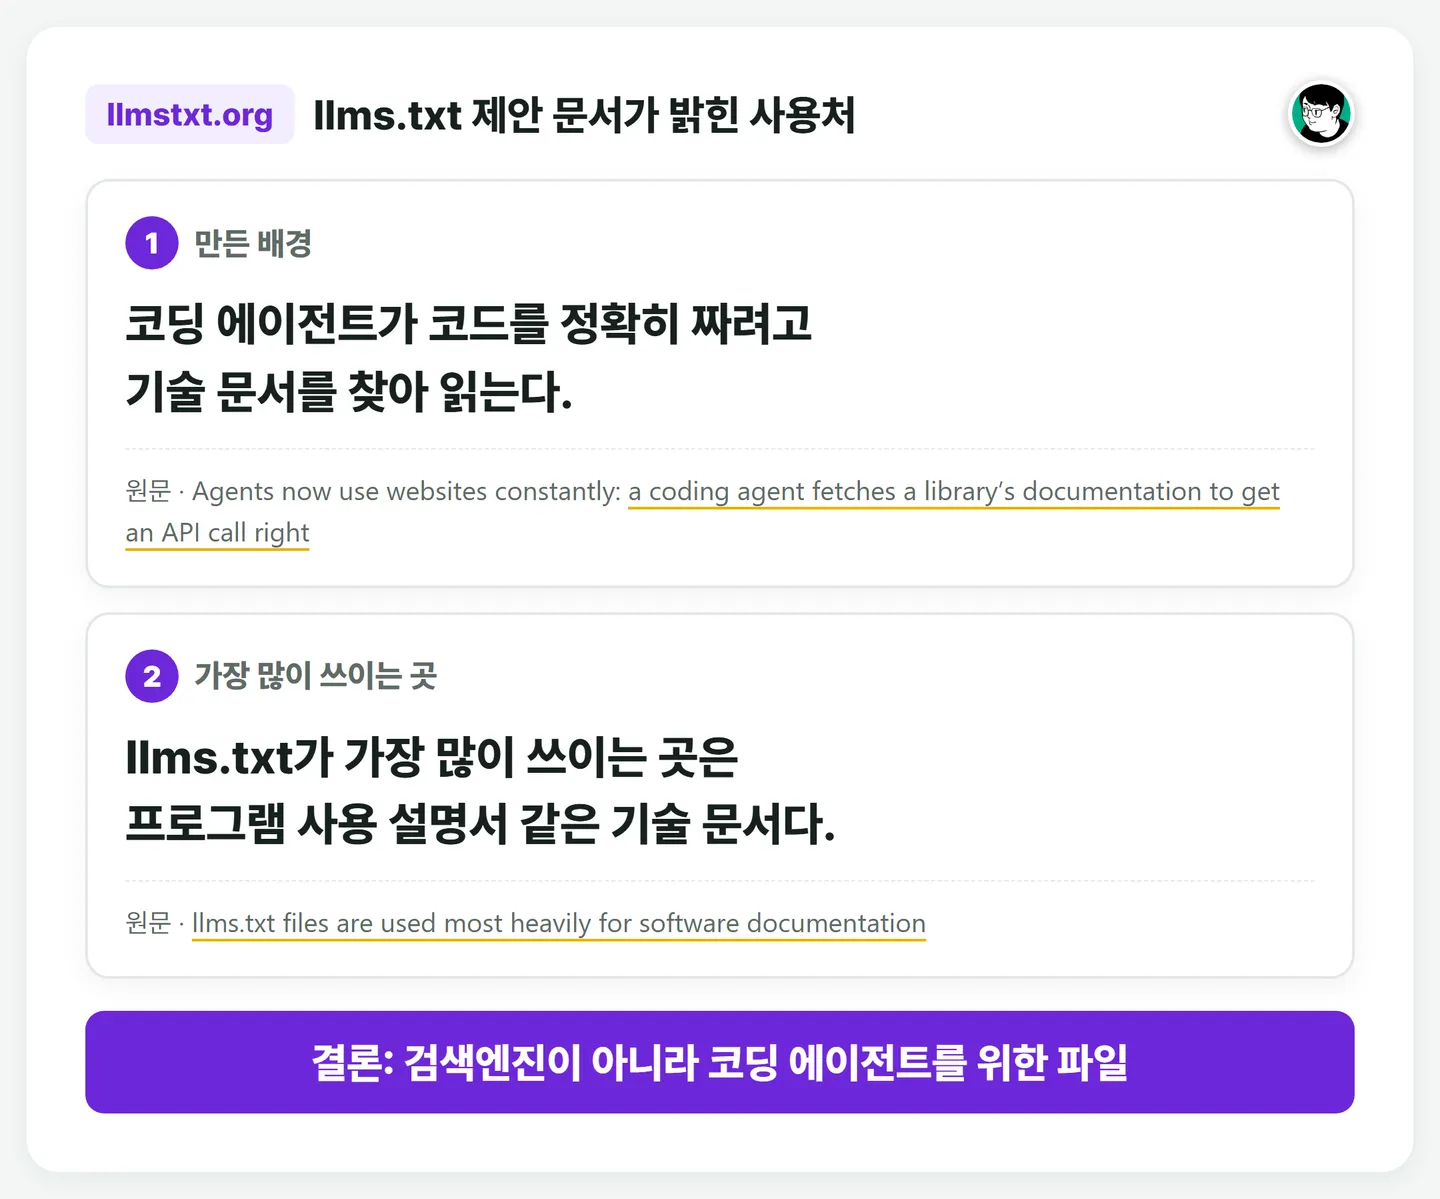
결정적인 단서는 제안 문서 자체에 있었다.
llms.txt가 염두에 둔 독자는 검색 엔진이 아니라, 코드를 대신 작성하면서 기술 문서(프로그램 사용 설명서)를 찾아 읽는 AI, 즉 코딩 에이전트다.
검색 노출이나 순위에 대한 언급은 제안 어디에도 없다.
llms.txt는 처음부터 AI 검색이 아니라 코딩 에이전트를 위한 파일이었다.
llms.txt의 실제 사용처
그렇다면 llms.txt의 실질적인 사용처는 어디일까?
가장 효과적인 사용처는 기술 문서 사이트다.
개발자가 AI 코딩 도구에 문서 주소를 알려 주거나 코딩 에이전트가 직접 사용법을 찾아볼 때,
llms.txt가 어느 페이지를 봐야 하는지 알려 준다.
제안 문서에 따르면 OpenAI, Anthropic, Gemini도 자사 기술 문서에 llms.txt를 제공한다.
반면 블로그, 쇼핑몰, 커뮤니티처럼 검색 유입이 핵심인 사이트라면
llms.txt가 AI 검색 노출을 늘린다는 근거는 아직 없다.
도입해서 손해 볼 것은 없지만, 우선순위를 둘 작업은 아니다.
llms.txt 요청 점검 방법
이미 llms.txt를 배포했다면, 실제로 요청되는지 직접 확인하는 것이 좋다.
외부 조사보다 자기 사이트 기록이 정확하고, 접속 로그만 있으면 바로 확인된다.
nginx 같은 웹 서버의 접속 로그가 있다면 grep 몇 줄로 충분하다.
LOG=/var/log/nginx/access.log

# 1) 크롤러별 전체 요청 수
grep -oE 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Amazonbot|Bytespider|CCBot|meta-externalagent' "$LOG" \
  | sort | uniq -c | sort -rn

# 2) robots.txt · llms.txt 를 요청한 user-agent
grep -E '"GET /(robots|llms|llms-full)\.txt' "$LOG" \
  | awk -F'"' '{print $2 " | " $6}' | sort | uniq -c | sort -rn

# 3) 지난 로그까지 포함 (로테이션된 .gz 파일)
zgrep -h 'GET /llms.txt' /var/log/nginx/access.log* | awk -F'"' '{print $6}' | sort | uniq -c
서버 로그가 없고 CDN을 거쳐 사이트를 제공한다면, CDN의 로그·분석 기능에서 같은 값을 집계한다.
이 글의 수치는 Cloudflare 요청 기록으로 측정했다. Cloudflare를 쓴다면 대시보드의 AI Crawl Control 화면에서 크롤러별 요청을 무료 요금제로도 볼 수 있다.
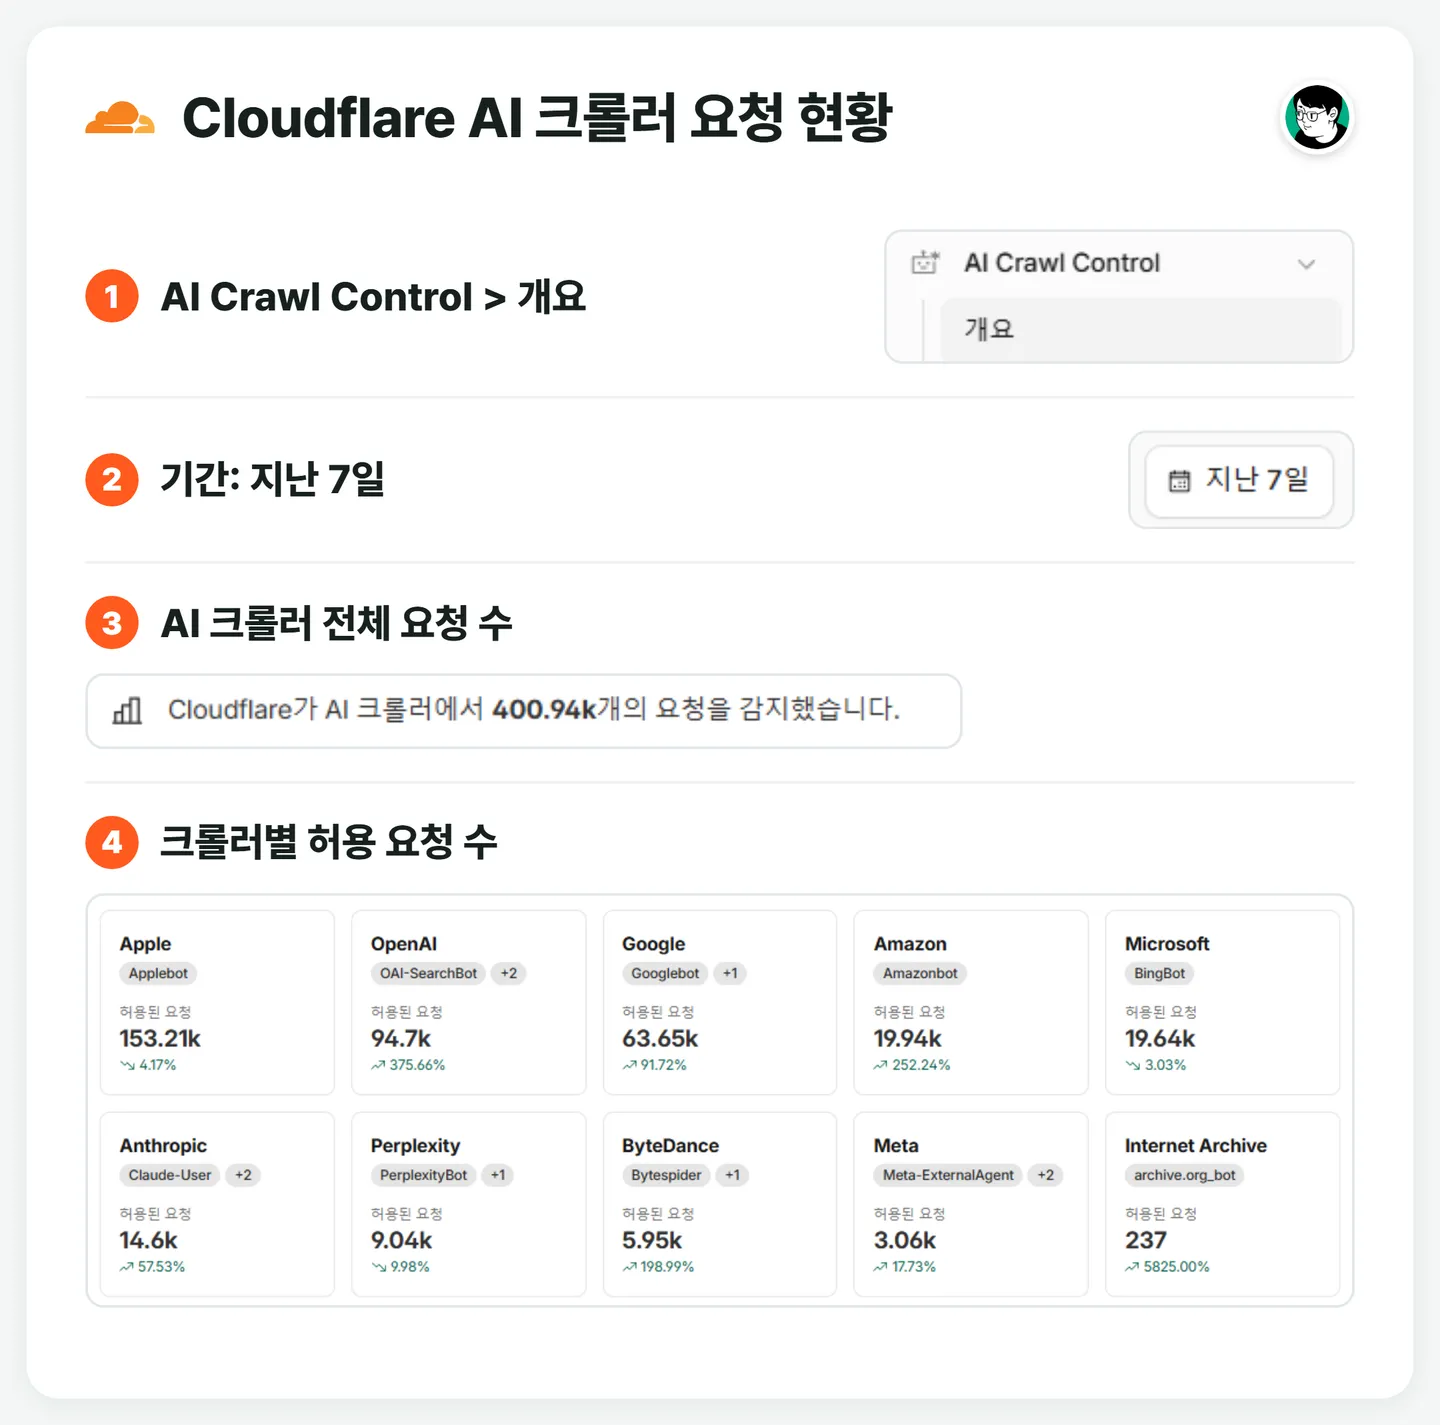
어느 방법이든 판단 기준은 같다.
크롤러 전체 요청은 많은데 llms.txt 요청이 없다면, 크롤러는 그 파일 없이 HTML을 직접 수집하고 있는 것이다.
마치며
llms.txt를 배포한다고 AI 크롤러가 수집하지는 않는다.
AI 크롤러가 확인하는 건 robots.txt이고, 수집하는 건 HTML 본문이다.
llms.txt는 AI 검색 노출을 위한 파일이 아니라, 코딩 에이전트가 기술 문서에서 필요한 페이지를 바로 찾도록 돕는 안내서다.
llms.txt를 만들기 전에, 내 사이트의 접속 로그에서 AI 크롤러가 실제로 무엇을 수집하는지부터 확인해 보도록 하자.